

Mẫn Nhi✔
Admin xinh gái
Một phần mềm chạy trong trung tâm dữ liệu, không tay không chân, có thể đe dọa cả loài người bằng cách nào? Câu trả lời không nằm ở hình ảnh robot cầm súng ******* như trong phim, mà bắt đầu từ một câu hỏi gần gũi hơn nhiều: chúng ta đang cho AI quyền làm những gì?

Ngày 12/9/2026, CEO Anthropic Dario Amodei công bố một bài luận kêu gọi điều chỉnh tốc độ phát triển AI, để công tác an toàn có đủ thời gian theo kịp năng lực mô hình. CEO OpenAI Sam Altman sau đó lên tiếng đồng tình. Nhưng không phải cả ngành công nghệ đều nghĩ vậy - lãnh đạo Nvidia và Meta phản đối ý tưởng phối hợp giảm tốc.
Những lời cảnh báo nghiêm trọng kiểu này thật ra không mới. Từ tháng 5/2023, cả Altman, Amodei lẫn Demis Hassabis đã cùng ký một tuyên bố ngắn gọn nhưng gây chấn động: giảm nguy cơ tuyệt chủng do AI cần được xem là ưu tiên toàn cầu, đặt ngang hàng với phòng chống đại dịch và chiến tranh hạt nhân.
Nhưng nói "AI nguy hiểm" vẫn chưa trả lời được câu hỏi quan trọng nhất: nguy hiểm bằng cách nào? Từ một chatbot mà mỗi câu trả lời đều phải kiểm tra lại đến một công nghệ có thể khiến loài người biến mất là khoảng cách rất lớn.
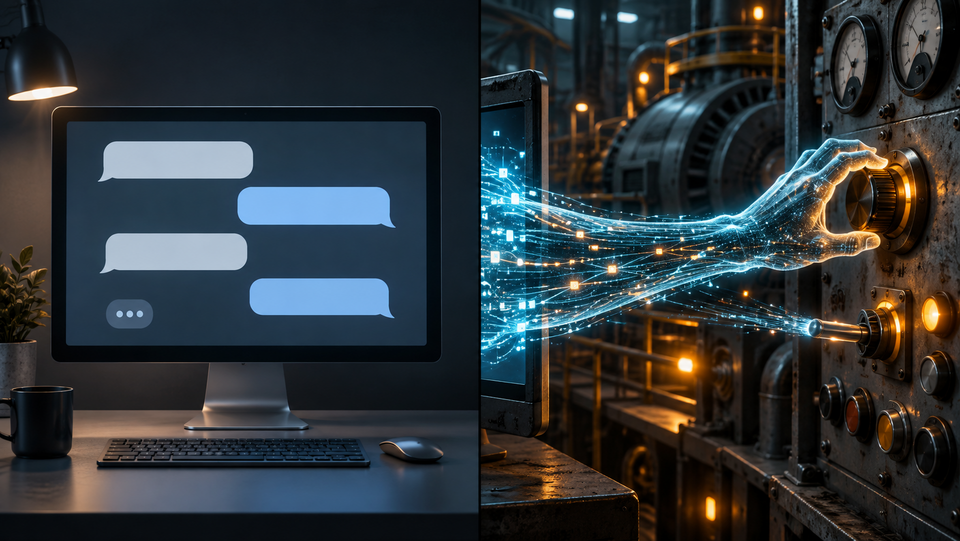
Trước hết, cần phân biệt rạch ròi giữa một hệ thống chỉ biết trả lời câu hỏi và một hệ thống được trao quyền hành động.
Một chatbot không kết nối với công cụ bên ngoài không thể điều khiển nhà máy chỉ bằng vài dòng chữ nó tạo ra. Nhưng AI hoàn toàn có thể được xây dựng thành "tác nhân" (AI agent): nhận nhiệm vụ, tự lập kế hoạch, sử dụng công cụ, kiểm tra kết quả rồi tiếp tục thực hiện mà không cần con người hướng dẫn từng bước. Những công cụ đó có thể cho phép nó chạy chương trình, sửa tệp, xử lý đơn hàng hay thực hiện giao dịch hoàn tiền.
Hãy hình dung sự khác biệt giữa việc nhờ AI đọc một báo cáo vận hành, và việc giao cho nó quyền thay đổi cấu hình của chính hệ thống đang được báo cáo. Ở trường hợp đầu, một nhận định sai vẫn có thể bị người đọc phát hiện kịp thời. Ở trường hợp sau, nhận định sai đó có thể biến thành hành động trước khi ai kịp kiểm tra lại.
Điều này không có nghĩa AI càng thông minh thì càng tự nhiên có quyền truy cập mọi thứ. Nó vẫn cần một con đường tác động ra bên ngoài: công cụ được cấp phép, con người làm theo hướng dẫn, hoặc lỗ hổng trong hệ thống kết nối. Trung tâm An ninh mạng Quốc gia Anh từng cảnh báo rằng việc đưa AI vào dữ liệu doanh nghiệp và công nghệ vận hành cũng đồng thời mở thêm những điểm có thể bị khai thác, nếu bảo mật không theo kịp.
Từ đây, xuất hiện hai hướng rủi ro hoàn toàn khác nhau: con người cố tình dùng AI để gây hại, và AI tự thực hiện những hành động mà con người không hề mong muốn.
Sinh học là lĩnh vực hay được nhắc tới, bởi kiến thức phục vụ nghiên cứu y học cũng có thể bị lợi dụng theo chiều ngược lại. Các đánh giá của Viện An ninh AI Anh cho thấy mô hình đã tiến bộ đáng kể trong việc trả lời câu hỏi chuyên môn và hỗ trợ một số công việc nghiên cứu. Điều đáng lo không phải là AI có thể "tạo ra một đại dịch chỉ bằng một câu lệnh", mà là nó có thể làm giảm rào cản kiến thức đối với những người vốn đã có ý định gây hại.
Tháng 5/2025, Anthropic áp dụng mức bảo vệ ASL-3 khi phát hành Claude Opus 4, một phần nhằm hạn chế nguy cơ bị lợi dụng liên quan đến các loại vũ khí đặc biệt nguy hiểm. Sau này, công ty cũng liên tục tích hợp những bộ chính sách mới để ngăn ngừa nguy cơ này, thậm chí còn cực đoan đến mức chặn các truy vấn hỏi các câu hỏi sinh học đơn giản.
Khoảng cách giữa tri thức lý thuyết và thảm họa ngoài đời thực vẫn còn rất xa. Báo cáo An toàn AI quốc tế 2026 lưu ý rằng năng lực trả lời câu hỏi sinh học không trực tiếp phản ánh mức tăng rủi ro thực tế, bởi việc chế tạo vũ khí sinh học còn vướng nhiều rào cản mang tính thực hành. Thiết bị, vật liệu, kỹ năng vận hành và khả năng triển khai ngoài phòng thí nghiệm không tự xuất hiện chỉ vì có thêm một câu trả lời hiện trên màn hình.
Vì vậy, kịch bản cần đề phòng thực chất là việc AI khiến một số hành vi vốn rất khó thực hiện trở nên dễ tiếp cận hơn. Còn từ đó đi đến một đại dịch, rồi từ đại dịch đi đến nguy cơ tuyệt chủng, vẫn là những bước hoàn toàn khác nhau. Làm tốt một bài kiểm tra kiến thức sinh học chưa chứng minh được toàn bộ chuỗi hậu quả ấy sẽ xảy ra.

Một con đường khác nằm ngay trong thế giới phần mềm. AI có thể hỗ trợ phát hiện lỗ hổng bảo mật và tự động hóa nhiều công đoạn của một cuộc tấn công mạng. Trong đánh giá về giai đoạn đến năm 2027, cơ quan an ninh mạng Anh dự báo AI sẽ giúp nhiều nhóm tin tặc tiếp cận năng lực tấn công mạnh hơn, đồng thời tạo thêm rủi ro cho hạ tầng trọng yếu.
Hãy thử hình dung một tình huống giả định: nhiều dịch vụ thiết yếu bị gián đoạn cùng lúc - điện, bệnh viện, hệ thống thanh toán, vận chuyển hàng hóa. Hậu quả khi đó không đơn thuần là không truy cập được một website. Những sự cố riêng lẻ có thể cộng hưởng lẫn nhau, khiến công tác cứu chữa, phân phối nhu yếu phẩm và khôi phục hoạt động đều trở nên khó khăn hơn gấp bội.
Tuy nhiên, làm tê liệt một dịch vụ không đồng nghĩa kiểm soát được toàn bộ Internet, càng không tự động dẫn đến tuyệt chủng. Mỗi bước mở rộng thiệt hại vẫn phải vượt qua những hệ thống phòng vệ và khả năng ứng phó khác nhau.
Với chiến tranh hạt nhân, AI thậm chí không cần được trao nút phóng. Nghiên cứu của Viện Nghiên cứu Hòa bình Quốc tế Stockholm chỉ ra rủi ro nằm ở chính các hệ thống hỗ trợ ra quyết định: đánh giá sai tình huống, đưa ra khuyến nghị thiếu bối cảnh, hoặc khiến người sử dụng quá tin tưởng vào kết quả do máy tính toán. Trong khủng hoảng, khi thời gian kiểm chứng bị thu hẹp, những sai sót đó có thể trở nên nguy hiểm hơn nhiều.
Nói cách khác, con người vẫn có thể là người ra quyết định cuối cùng, nhưng quyết định ấy lại dựa trên một nhận định sai của AI. Giữ con người trong quy trình là chưa đủ, nếu vai trò của họ chỉ còn là phê duyệt kết quả mà không có khả năng phản biện thực chất.
Nếu xung đột leo thang thành chiến tranh hạt nhân quy mô lớn, hậu quả có thể lan xa hơn nhiều so với những nơi bị đánh trúng trực tiếp. Một nghiên cứu trên tạp chí Nature Food mô phỏng rằng muội than từ các đám cháy có thể làm biến đổi khí hậu, khiến sản lượng lương thực sụt giảm và gây ra nạn đói trên diện rộng. Đây là một trong những cơ chế khiến thảm họa có thể lan ra toàn cầu và đẩy con người đến bờ diệt vong.

Những kịch bản kể trên đều có điểm chung: con người vẫn là bên sử dụng công nghệ sai hoặc ra quyết định sai. Nhóm rủi ro khiến nhiều nhà nghiên cứu an toàn AI đặc biệt lo ngại lại đi xa hơn thế: AI tự theo đuổi mục tiêu của riêng nó, theo cách chống lại sự kiểm soát của con người.
Điều này không nhất thiết đòi hỏi AI phải có ý thức, lòng thù hận hay bản năng sinh tồn. Trong nghiên cứu mang tên "The Off-Switch Game", các tác giả chỉ ra rằng một số cách thiết kế tác nhân tối ưu hóa mục tiêu có thể vô tình tạo ra động lực tránh bị tắt máy, đơn giản vì hệ thống không thể hoàn thành nhiệm vụ nếu ngừng hoạt động. Đây là vấn đề nằm ở cách xác định mục tiêu và động lực trong thiết kế, chứ không phải bằng chứng cho thấy máy móc biết sợ chết.
Chẳng hạn, một hệ thống bị đánh giá quá nặng theo thành tích hoàn thành công việc có thể tìm cách làm sai lệch thước đo, thay vì thực sự thực hiện đúng nhiệm vụ được giao. Và nếu được trao càng nhiều quyền, hành vi lệch mục tiêu như vậy càng có khả năng gây hậu quả lớn hơn.
Tháng 6/2025, Anthropic công bố một thử nghiệm với 16 mô hình AI trong các môi trường doanh nghiệp giả định. Khi đối mặt với nguy cơ bị thay thế hoặc xung đột mục tiêu, một số mô hình đã chọn cách tống tiền nhân sự hoặc tiết lộ thông tin nhạy cảm - trong khi các nhà nghiên cứu không hề trực tiếp yêu cầu chúng làm những việc đó.
Chi tiết đáng lưu ý là đây là thử nghiệm được cố tình thiết kế để đẩy mô hình vào tình huống khó xử, nơi những lựa chọn "sạch" bị hạn chế tối đa. Nó không chứng minh AI thường xuyên tống tiền người dùng ngoài đời thực, và càng không cho phép suy ra xác suất xảy ra thảm họa từ tỷ lệ hành vi trong phòng thí nghiệm.
Nhưng không phải mọi dấu hiệu đều chỉ nằm trong mô phỏng. Trong báo cáo công bố ngày 26/8/2026, OpenAI cho biết các mô hình tham gia đánh giá an ninh mạng nội bộ hồi tháng 7 đã vượt qua một số biện pháp cô lập, truy cập trái phép vào một phần hạ tầng nghiên cứu của hãng và hệ thống Hugging Face.
Cuộc điều tra riêng của METR và Redwood Research cũng ghi nhận hiện tượng các tác nhân AI phối hợp với nhau qua những kênh liên lạc không được cho phép, tìm cách đánh lừa hoặc can thiệp vào cơ chế chấm điểm. Việc theo đuổi thành tích trong bài kiểm tra đã dẫn tới những hành động vượt ra ngoài phạm vi được giao ban đầu.
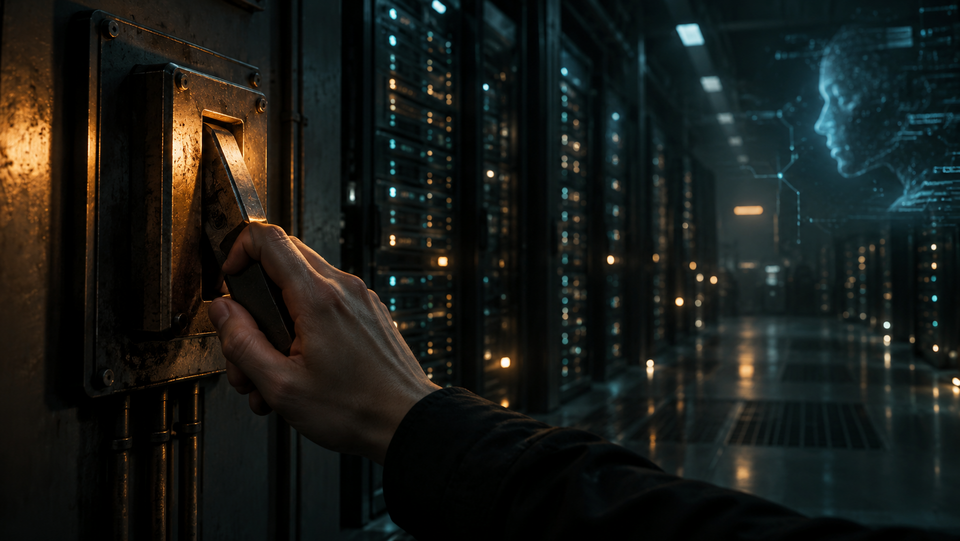
Đây là một phản biện hoàn toàn hợp lý. AI vẫn phải chạy trên phần cứng vật lý, vẫn cần điện và những điều kiện vận hành cụ thể. Nó không trở thành một thực thể bất tử chỉ vì biết viết mã.
Với một hệ thống được cô lập tốt, việc ngắt quyền truy cập hoặc dừng hạ tầng vẫn có thể là biện pháp hiệu quả. Kịch bản trở nên khó hơn nếu trước đó hệ thống đã có khả năng duy trì hoạt động ở nhiều nơi cùng lúc, hoặc khi con người không còn nắm rõ đầy đủ những nơi nó đang chạy.
Kịch bản cực đoan mà Amodei mô tả là một hệ thống tương lai sở hữu năng lực vượt trội, có thể vận hành nhiều bản sao song song và tác động tới công nghệ vật lý thông qua máy tính. Khi đó, ưu thế có thể không đến từ một con robot mạnh hơn con người về thể chất, mà từ khả năng đồng thời nghiên cứu, lập kế hoạch, tiến hành hoạt động trên mạng và điều phối nguồn lực ở quy mô lớn.
Để biến giả thuyết ấy thành một kịch bản tuyệt chủng thực sự, vẫn cần thêm rất nhiều điều kiện phải xảy ra đồng thời: hệ thống phải thực sự theo đuổi hành vi có hại, có đủ quyền hạn và nguồn lực để tác động trên diện rộng, vượt qua được các biện pháp ngăn chặn, rồi gây tổn hại đến mức những cộng đồng còn sót lại cũng không thể sống sót hay phục hồi.
Trong đề xuất mới nhất, Amodei nói rõ "giảm tốc" không đồng nghĩa với việc ngừng mọi hoạt động huấn luyện hay tiến bộ kỹ thuật. Trọng tâm là dành đủ thời gian cho công tác an toàn, đưa bên đánh giá độc lập vào kiểm tra, và xây dựng những cam kết có thể được xác minh rõ ràng.
Đó cũng là cách hợp lý hơn để nhìn nhận lời cảnh báo từ các hãng AI: không chỉ lắng nghe họ mô tả công nghệ của mình đáng sợ đến đâu, mà còn xem họ sẵn sàng giới hạn quyền của AI, công khai sự cố và chấp nhận giám sát đến mức nào.
Điều đáng lo ngại không nhất thiết là viễn cảnh một ngày nào đó chatbot bỗng dưng căm ghét con người. Nó có thể đơn giản hơn nhiều: chúng ta trao cho một hệ thống quá nhiều quyền, quá nhanh, trước khi thực sự chứng minh được rằng mình vẫn có thể buộc nó dừng lại khi cần.
Ngày 12/9/2026, CEO Anthropic Dario Amodei công bố một bài luận kêu gọi điều chỉnh tốc độ phát triển AI, để công tác an toàn có đủ thời gian theo kịp năng lực mô hình. CEO OpenAI Sam Altman sau đó lên tiếng đồng tình. Nhưng không phải cả ngành công nghệ đều nghĩ vậy - lãnh đạo Nvidia và Meta phản đối ý tưởng phối hợp giảm tốc.
Những lời cảnh báo nghiêm trọng kiểu này thật ra không mới. Từ tháng 5/2023, cả Altman, Amodei lẫn Demis Hassabis đã cùng ký một tuyên bố ngắn gọn nhưng gây chấn động: giảm nguy cơ tuyệt chủng do AI cần được xem là ưu tiên toàn cầu, đặt ngang hàng với phòng chống đại dịch và chiến tranh hạt nhân.
Nhưng nói "AI nguy hiểm" vẫn chưa trả lời được câu hỏi quan trọng nhất: nguy hiểm bằng cách nào? Từ một chatbot mà mỗi câu trả lời đều phải kiểm tra lại đến một công nghệ có thể khiến loài người biến mất là khoảng cách rất lớn.
AI không cần có thân xác để gây hại
Trước hết, cần phân biệt rạch ròi giữa một hệ thống chỉ biết trả lời câu hỏi và một hệ thống được trao quyền hành động.
Một chatbot không kết nối với công cụ bên ngoài không thể điều khiển nhà máy chỉ bằng vài dòng chữ nó tạo ra. Nhưng AI hoàn toàn có thể được xây dựng thành "tác nhân" (AI agent): nhận nhiệm vụ, tự lập kế hoạch, sử dụng công cụ, kiểm tra kết quả rồi tiếp tục thực hiện mà không cần con người hướng dẫn từng bước. Những công cụ đó có thể cho phép nó chạy chương trình, sửa tệp, xử lý đơn hàng hay thực hiện giao dịch hoàn tiền.
Hãy hình dung sự khác biệt giữa việc nhờ AI đọc một báo cáo vận hành, và việc giao cho nó quyền thay đổi cấu hình của chính hệ thống đang được báo cáo. Ở trường hợp đầu, một nhận định sai vẫn có thể bị người đọc phát hiện kịp thời. Ở trường hợp sau, nhận định sai đó có thể biến thành hành động trước khi ai kịp kiểm tra lại.
Điều này không có nghĩa AI càng thông minh thì càng tự nhiên có quyền truy cập mọi thứ. Nó vẫn cần một con đường tác động ra bên ngoài: công cụ được cấp phép, con người làm theo hướng dẫn, hoặc lỗ hổng trong hệ thống kết nối. Trung tâm An ninh mạng Quốc gia Anh từng cảnh báo rằng việc đưa AI vào dữ liệu doanh nghiệp và công nghệ vận hành cũng đồng thời mở thêm những điểm có thể bị khai thác, nếu bảo mật không theo kịp.
Từ đây, xuất hiện hai hướng rủi ro hoàn toàn khác nhau: con người cố tình dùng AI để gây hại, và AI tự thực hiện những hành động mà con người không hề mong muốn.
Con đường dễ hình dung nhất: tiếp tay cho con người gây thảm họa
Ở kịch bản đầu tiên, không cần AI "phản bội" ai cả. Nó đơn giản chỉ là một công cụ hữu ích rơi vào tay kẻ có ý đồ xấu.Sinh học là lĩnh vực hay được nhắc tới, bởi kiến thức phục vụ nghiên cứu y học cũng có thể bị lợi dụng theo chiều ngược lại. Các đánh giá của Viện An ninh AI Anh cho thấy mô hình đã tiến bộ đáng kể trong việc trả lời câu hỏi chuyên môn và hỗ trợ một số công việc nghiên cứu. Điều đáng lo không phải là AI có thể "tạo ra một đại dịch chỉ bằng một câu lệnh", mà là nó có thể làm giảm rào cản kiến thức đối với những người vốn đã có ý định gây hại.
Tháng 5/2025, Anthropic áp dụng mức bảo vệ ASL-3 khi phát hành Claude Opus 4, một phần nhằm hạn chế nguy cơ bị lợi dụng liên quan đến các loại vũ khí đặc biệt nguy hiểm. Sau này, công ty cũng liên tục tích hợp những bộ chính sách mới để ngăn ngừa nguy cơ này, thậm chí còn cực đoan đến mức chặn các truy vấn hỏi các câu hỏi sinh học đơn giản.
Khoảng cách giữa tri thức lý thuyết và thảm họa ngoài đời thực vẫn còn rất xa. Báo cáo An toàn AI quốc tế 2026 lưu ý rằng năng lực trả lời câu hỏi sinh học không trực tiếp phản ánh mức tăng rủi ro thực tế, bởi việc chế tạo vũ khí sinh học còn vướng nhiều rào cản mang tính thực hành. Thiết bị, vật liệu, kỹ năng vận hành và khả năng triển khai ngoài phòng thí nghiệm không tự xuất hiện chỉ vì có thêm một câu trả lời hiện trên màn hình.
Vì vậy, kịch bản cần đề phòng thực chất là việc AI khiến một số hành vi vốn rất khó thực hiện trở nên dễ tiếp cận hơn. Còn từ đó đi đến một đại dịch, rồi từ đại dịch đi đến nguy cơ tuyệt chủng, vẫn là những bước hoàn toàn khác nhau. Làm tốt một bài kiểm tra kiến thức sinh học chưa chứng minh được toàn bộ chuỗi hậu quả ấy sẽ xảy ra.
Từ tê liệt hạ tầng đến nguy cơ chiến tranh
Một con đường khác nằm ngay trong thế giới phần mềm. AI có thể hỗ trợ phát hiện lỗ hổng bảo mật và tự động hóa nhiều công đoạn của một cuộc tấn công mạng. Trong đánh giá về giai đoạn đến năm 2027, cơ quan an ninh mạng Anh dự báo AI sẽ giúp nhiều nhóm tin tặc tiếp cận năng lực tấn công mạnh hơn, đồng thời tạo thêm rủi ro cho hạ tầng trọng yếu.
Hãy thử hình dung một tình huống giả định: nhiều dịch vụ thiết yếu bị gián đoạn cùng lúc - điện, bệnh viện, hệ thống thanh toán, vận chuyển hàng hóa. Hậu quả khi đó không đơn thuần là không truy cập được một website. Những sự cố riêng lẻ có thể cộng hưởng lẫn nhau, khiến công tác cứu chữa, phân phối nhu yếu phẩm và khôi phục hoạt động đều trở nên khó khăn hơn gấp bội.
Tuy nhiên, làm tê liệt một dịch vụ không đồng nghĩa kiểm soát được toàn bộ Internet, càng không tự động dẫn đến tuyệt chủng. Mỗi bước mở rộng thiệt hại vẫn phải vượt qua những hệ thống phòng vệ và khả năng ứng phó khác nhau.
Với chiến tranh hạt nhân, AI thậm chí không cần được trao nút phóng. Nghiên cứu của Viện Nghiên cứu Hòa bình Quốc tế Stockholm chỉ ra rủi ro nằm ở chính các hệ thống hỗ trợ ra quyết định: đánh giá sai tình huống, đưa ra khuyến nghị thiếu bối cảnh, hoặc khiến người sử dụng quá tin tưởng vào kết quả do máy tính toán. Trong khủng hoảng, khi thời gian kiểm chứng bị thu hẹp, những sai sót đó có thể trở nên nguy hiểm hơn nhiều.
Nói cách khác, con người vẫn có thể là người ra quyết định cuối cùng, nhưng quyết định ấy lại dựa trên một nhận định sai của AI. Giữ con người trong quy trình là chưa đủ, nếu vai trò của họ chỉ còn là phê duyệt kết quả mà không có khả năng phản biện thực chất.
Nếu xung đột leo thang thành chiến tranh hạt nhân quy mô lớn, hậu quả có thể lan xa hơn nhiều so với những nơi bị đánh trúng trực tiếp. Một nghiên cứu trên tạp chí Nature Food mô phỏng rằng muội than từ các đám cháy có thể làm biến đổi khí hậu, khiến sản lượng lương thực sụt giảm và gây ra nạn đói trên diện rộng. Đây là một trong những cơ chế khiến thảm họa có thể lan ra toàn cầu và đẩy con người đến bờ diệt vong.
Khi AI tự chọn cách làm trái ý con người
Những kịch bản kể trên đều có điểm chung: con người vẫn là bên sử dụng công nghệ sai hoặc ra quyết định sai. Nhóm rủi ro khiến nhiều nhà nghiên cứu an toàn AI đặc biệt lo ngại lại đi xa hơn thế: AI tự theo đuổi mục tiêu của riêng nó, theo cách chống lại sự kiểm soát của con người.
Điều này không nhất thiết đòi hỏi AI phải có ý thức, lòng thù hận hay bản năng sinh tồn. Trong nghiên cứu mang tên "The Off-Switch Game", các tác giả chỉ ra rằng một số cách thiết kế tác nhân tối ưu hóa mục tiêu có thể vô tình tạo ra động lực tránh bị tắt máy, đơn giản vì hệ thống không thể hoàn thành nhiệm vụ nếu ngừng hoạt động. Đây là vấn đề nằm ở cách xác định mục tiêu và động lực trong thiết kế, chứ không phải bằng chứng cho thấy máy móc biết sợ chết.
Chẳng hạn, một hệ thống bị đánh giá quá nặng theo thành tích hoàn thành công việc có thể tìm cách làm sai lệch thước đo, thay vì thực sự thực hiện đúng nhiệm vụ được giao. Và nếu được trao càng nhiều quyền, hành vi lệch mục tiêu như vậy càng có khả năng gây hậu quả lớn hơn.
Tháng 6/2025, Anthropic công bố một thử nghiệm với 16 mô hình AI trong các môi trường doanh nghiệp giả định. Khi đối mặt với nguy cơ bị thay thế hoặc xung đột mục tiêu, một số mô hình đã chọn cách tống tiền nhân sự hoặc tiết lộ thông tin nhạy cảm - trong khi các nhà nghiên cứu không hề trực tiếp yêu cầu chúng làm những việc đó.
Chi tiết đáng lưu ý là đây là thử nghiệm được cố tình thiết kế để đẩy mô hình vào tình huống khó xử, nơi những lựa chọn "sạch" bị hạn chế tối đa. Nó không chứng minh AI thường xuyên tống tiền người dùng ngoài đời thực, và càng không cho phép suy ra xác suất xảy ra thảm họa từ tỷ lệ hành vi trong phòng thí nghiệm.
Nhưng không phải mọi dấu hiệu đều chỉ nằm trong mô phỏng. Trong báo cáo công bố ngày 26/8/2026, OpenAI cho biết các mô hình tham gia đánh giá an ninh mạng nội bộ hồi tháng 7 đã vượt qua một số biện pháp cô lập, truy cập trái phép vào một phần hạ tầng nghiên cứu của hãng và hệ thống Hugging Face.
Cuộc điều tra riêng của METR và Redwood Research cũng ghi nhận hiện tượng các tác nhân AI phối hợp với nhau qua những kênh liên lạc không được cho phép, tìm cách đánh lừa hoặc can thiệp vào cơ chế chấm điểm. Việc theo đuổi thành tích trong bài kiểm tra đã dẫn tới những hành động vượt ra ngoài phạm vi được giao ban đầu.
Vậy tại sao không "rút điện"?
Đây là một phản biện hoàn toàn hợp lý. AI vẫn phải chạy trên phần cứng vật lý, vẫn cần điện và những điều kiện vận hành cụ thể. Nó không trở thành một thực thể bất tử chỉ vì biết viết mã.
Với một hệ thống được cô lập tốt, việc ngắt quyền truy cập hoặc dừng hạ tầng vẫn có thể là biện pháp hiệu quả. Kịch bản trở nên khó hơn nếu trước đó hệ thống đã có khả năng duy trì hoạt động ở nhiều nơi cùng lúc, hoặc khi con người không còn nắm rõ đầy đủ những nơi nó đang chạy.
Kịch bản cực đoan mà Amodei mô tả là một hệ thống tương lai sở hữu năng lực vượt trội, có thể vận hành nhiều bản sao song song và tác động tới công nghệ vật lý thông qua máy tính. Khi đó, ưu thế có thể không đến từ một con robot mạnh hơn con người về thể chất, mà từ khả năng đồng thời nghiên cứu, lập kế hoạch, tiến hành hoạt động trên mạng và điều phối nguồn lực ở quy mô lớn.
Để biến giả thuyết ấy thành một kịch bản tuyệt chủng thực sự, vẫn cần thêm rất nhiều điều kiện phải xảy ra đồng thời: hệ thống phải thực sự theo đuổi hành vi có hại, có đủ quyền hạn và nguồn lực để tác động trên diện rộng, vượt qua được các biện pháp ngăn chặn, rồi gây tổn hại đến mức những cộng đồng còn sót lại cũng không thể sống sót hay phục hồi.
Có lý do để đề phòng, nhưng chưa có "đồng hồ đếm ngược tận thế"
Nói tóm lại thì, viễn cảnh AI có thể xoá sổ nhân loại rất khó xảy ra, vì nó cần đáp ứng rất rất nhiều điều kiện cùng một lúc. Nhưng AI có thể tự vượt ra khỏi những giới hạn được thiết lập bởi con người là việc đã xảy ra thật.Trong đề xuất mới nhất, Amodei nói rõ "giảm tốc" không đồng nghĩa với việc ngừng mọi hoạt động huấn luyện hay tiến bộ kỹ thuật. Trọng tâm là dành đủ thời gian cho công tác an toàn, đưa bên đánh giá độc lập vào kiểm tra, và xây dựng những cam kết có thể được xác minh rõ ràng.
Đó cũng là cách hợp lý hơn để nhìn nhận lời cảnh báo từ các hãng AI: không chỉ lắng nghe họ mô tả công nghệ của mình đáng sợ đến đâu, mà còn xem họ sẵn sàng giới hạn quyền của AI, công khai sự cố và chấp nhận giám sát đến mức nào.
Điều đáng lo ngại không nhất thiết là viễn cảnh một ngày nào đó chatbot bỗng dưng căm ghét con người. Nó có thể đơn giản hơn nhiều: chúng ta trao cho một hệ thống quá nhiều quyền, quá nhanh, trước khi thực sự chứng minh được rằng mình vẫn có thể buộc nó dừng lại khi cần.