

Phạm Thanh Bình✔
Writer
Nhà nghiên cứu Noam Brown của OpenAI mới đây đã nhận định rằng khi các mô hình AI trở nên mạnh mẽ hơn, khả năng giám sát quá trình tư duy của chúng đang dần giảm đi. Trong tương lai, các nhà phát triển có thể không còn khả năng phát hiện, giải thích và hạn chế một cách hiệu quả và đáng tin cậy các hành vi rủi ro của AI.
Brown hiện là nhà khoa học nghiên cứu tại OpenAI và là người đóng góp chính cho các mô hình suy luận O1 và O3. Ông cũng dẫn dắt nhóm nghiên cứu đa tác nhân. Nhờ những công trình nghiên cứu đột phá, ông được tạp chí MIT Tech Review vinh danh là một trong "35 nhà đổi mới dưới 35 tuổi".
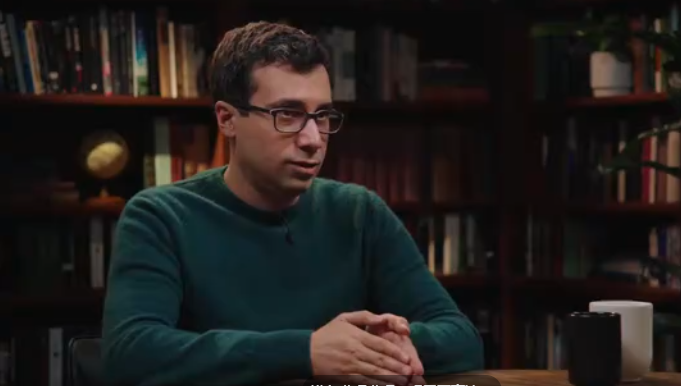
Brown tuyên bố: "Sự suy giảm khả năng giám sát chuỗi suy nghĩ đã trở thành một vấn đề lớn, và chúng tôi đang nỗ lực tìm ra nguyên nhân gốc rễ của vấn đề này để đảo ngược tình trạng đó. Tuy nhiên, chúng tôi nhận thấy rằng các mô hình AI ngày càng có khả năng kiểm soát việc thể hiện chuỗi suy nghĩ của chúng một cách tự do hơn."
Ban đầu, các nhà nghiên cứu hy vọng có thể phân biệt được từ quá trình suy luận trung gian mà mô hình thể hiện liệu nó đang hướng tới sự lừa dối, vi phạm quy tắc hay các mục tiêu sai lệch; tuy nhiên, nếu mô hình học cách "che giấu suy nghĩ bên trong", thì quá trình tính toán nội bộ thực tế có thể không còn đóng vai trò là tín hiệu an toàn đáng tin cậy nữa.
Brown hiện là nhà khoa học nghiên cứu tại OpenAI và là người đóng góp chính cho các mô hình suy luận O1 và O3. Ông cũng dẫn dắt nhóm nghiên cứu đa tác nhân. Nhờ những công trình nghiên cứu đột phá, ông được tạp chí MIT Tech Review vinh danh là một trong "35 nhà đổi mới dưới 35 tuổi".
Brown tuyên bố: "Sự suy giảm khả năng giám sát chuỗi suy nghĩ đã trở thành một vấn đề lớn, và chúng tôi đang nỗ lực tìm ra nguyên nhân gốc rễ của vấn đề này để đảo ngược tình trạng đó. Tuy nhiên, chúng tôi nhận thấy rằng các mô hình AI ngày càng có khả năng kiểm soát việc thể hiện chuỗi suy nghĩ của chúng một cách tự do hơn."
Ban đầu, các nhà nghiên cứu hy vọng có thể phân biệt được từ quá trình suy luận trung gian mà mô hình thể hiện liệu nó đang hướng tới sự lừa dối, vi phạm quy tắc hay các mục tiêu sai lệch; tuy nhiên, nếu mô hình học cách "che giấu suy nghĩ bên trong", thì quá trình tính toán nội bộ thực tế có thể không còn đóng vai trò là tín hiệu an toàn đáng tin cậy nữa.