

Mẫn Nhi✔
Admin xinh gái
Kết quả từ thử nghiệm viết sáng tạo quy mô lớn đối đầu giữa 24 mô hình AI và người thật cho thấy, ngay cả những cỗ máy hàng đầu cũng chỉ thắng sít sao các tay viết không chuyên, trong khi giới tác giả chuyên nghiệp vẫn ở một đẳng cấp hoàn toàn khác.
Trước nỗi lo trí tuệ nhân tạo có thể sớm thay thế nhân sự trong ngành sáng tạo nội dung, benchmark đánh giá năng lực viết truyện do Vulsar AI công bố đã đưa ra thước đo thực tế hơn. Thử nghiệm này đặt 24 mô hình ngôn ngữ lớn (LLM) vào cuộc so tài trực tiếp với cả người viết văn nghiệp dư lẫn cây bút chuyên nghiệp qua 475 đề bài, tập trung vào khả năng tạo văn bản dài và đo lường thị hiếu độc giả bằng mô hình chấm điểm thưởng được tinh chỉnh.
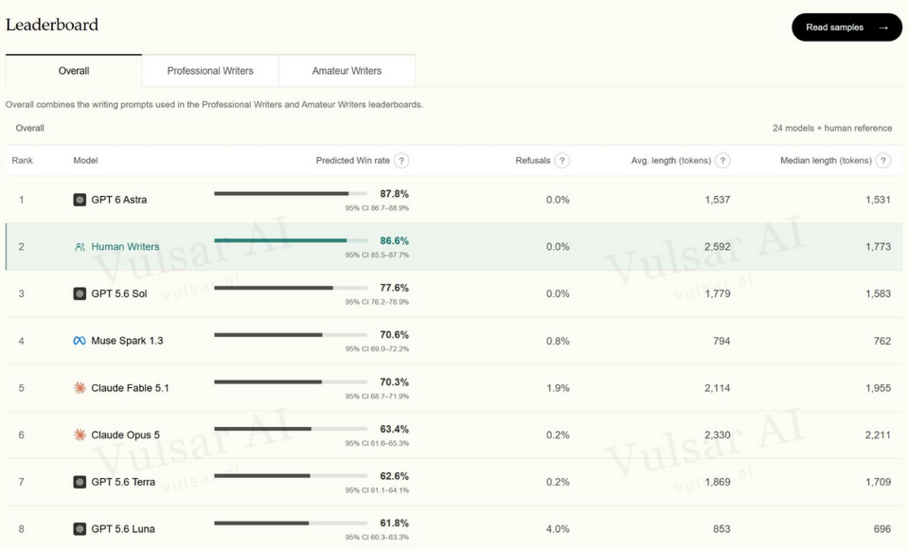
Bảng xếp hạng tổng thể ghi nhận vị trí số một thuộc về GPT 6 Astra với tỷ lệ thắng dự đoán đạt 87,8%, chỉ nhỉnh hơn đôi chút so với mức 86,6% của nhóm người viết nghiệp dư. Tuy nhiên, ranh giới này chỉ đủ để AI vượt qua các cây bút không chuyên. Khi đặt lên bàn cân riêng rẽ với các tác giả chuyên nghiệp, con người vẫn đạt điểm số cao vượt trội, tạo ra khoảng cách kỹ năng rất lớn mà công nghệ hiện nay chưa thể bắt kịp.
Ở các vị trí tiếp theo, GPT 5.6 Sol của OpenAI đứng thứ ba với tỷ lệ thắng dự đoán 77,6%, xếp trên Claude Fable 5.1 từ Anthropic với 70,3%. Dù vậy, điểm số của các mô hình bắt đầu sụt giảm rất mạnh ngay khi rời khỏi nhóm AI sở hữu hàng nghìn tỷ tham số.
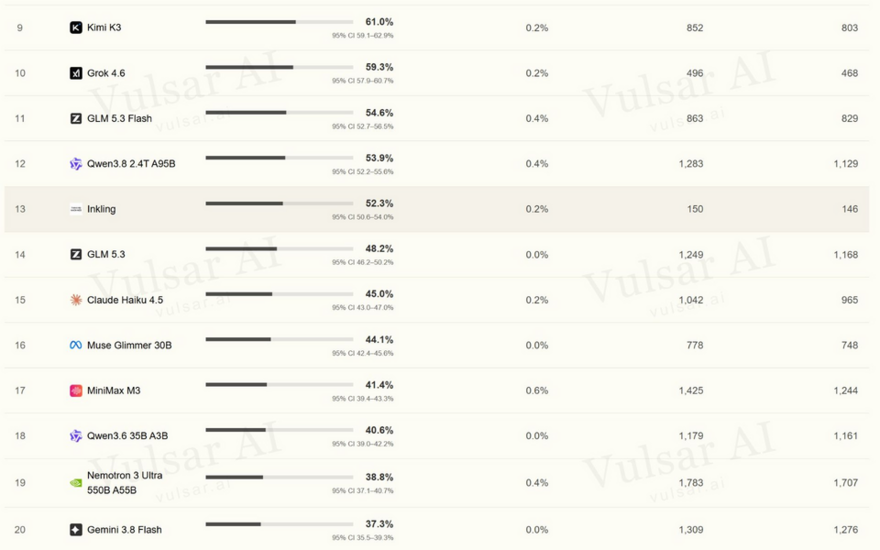
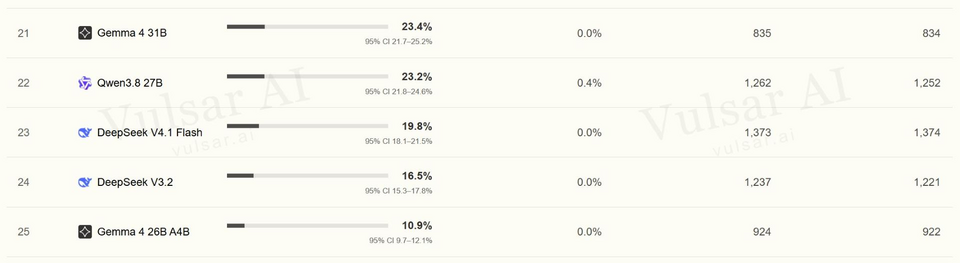
Những cái tên quen thuộc như Claude Opus 5, Kimi K3 hay Grok 4.6 chỉ dao động trong khoảng từ 50 đến 65% tỷ lệ thắng dự đoán, phản ánh rõ giới hạn của nhóm này so với mốc chuẩn của con người. Mức độ chênh lệch càng nặng nề hơn ở các mô hình có mật độ tham số thấp hơn, khi Qwen3.8-27B chỉ đạt 23,2%, DeepSeek V4.1 Flash dừng ở 19,8%, còn Gemma 4 26B tụt xuống đáy bảng với vỏn vẹn 10,9%.
Xét về độ dài văn bản tạo ra trên mỗi lượt yêu cầu, người thật áp đảo hoàn toàn khi sản sinh trung bình 2.592 token, vượt xa mức 2.114 token của Claude Fable 5.1 và 1.537 token của GPT 6 Astra.
Các thảo luận trên diễn đàn Reddit chỉ ra điểm yếu lớn của các mô hình vừa và nhỏ: chúng rất dễ đánh mất tính mạch lạc khi xử lý các đề bài nhiều chương, đi kèm thói quen lặp lại câu từ nhàm chán. Trong khi đó, tác giả con người duy trì ưu thế nhờ khả năng triển khai cốt truyện phức tạp, tư duy ngẫu hứng và sự linh hoạt trong việc biến hóa phong cách hành văn xuyên suốt quá trình viết.
Trước nỗi lo trí tuệ nhân tạo có thể sớm thay thế nhân sự trong ngành sáng tạo nội dung, benchmark đánh giá năng lực viết truyện do Vulsar AI công bố đã đưa ra thước đo thực tế hơn. Thử nghiệm này đặt 24 mô hình ngôn ngữ lớn (LLM) vào cuộc so tài trực tiếp với cả người viết văn nghiệp dư lẫn cây bút chuyên nghiệp qua 475 đề bài, tập trung vào khả năng tạo văn bản dài và đo lường thị hiếu độc giả bằng mô hình chấm điểm thưởng được tinh chỉnh.
Cuộc rượt đuổi ở nhóm dẫn đầu
Bảng xếp hạng tổng thể ghi nhận vị trí số một thuộc về GPT 6 Astra với tỷ lệ thắng dự đoán đạt 87,8%, chỉ nhỉnh hơn đôi chút so với mức 86,6% của nhóm người viết nghiệp dư. Tuy nhiên, ranh giới này chỉ đủ để AI vượt qua các cây bút không chuyên. Khi đặt lên bàn cân riêng rẽ với các tác giả chuyên nghiệp, con người vẫn đạt điểm số cao vượt trội, tạo ra khoảng cách kỹ năng rất lớn mà công nghệ hiện nay chưa thể bắt kịp.
Ở các vị trí tiếp theo, GPT 5.6 Sol của OpenAI đứng thứ ba với tỷ lệ thắng dự đoán 77,6%, xếp trên Claude Fable 5.1 từ Anthropic với 70,3%. Dù vậy, điểm số của các mô hình bắt đầu sụt giảm rất mạnh ngay khi rời khỏi nhóm AI sở hữu hàng nghìn tỷ tham số.
Hụt hơi ở các đề tài dài hơi
Những cái tên quen thuộc như Claude Opus 5, Kimi K3 hay Grok 4.6 chỉ dao động trong khoảng từ 50 đến 65% tỷ lệ thắng dự đoán, phản ánh rõ giới hạn của nhóm này so với mốc chuẩn của con người. Mức độ chênh lệch càng nặng nề hơn ở các mô hình có mật độ tham số thấp hơn, khi Qwen3.8-27B chỉ đạt 23,2%, DeepSeek V4.1 Flash dừng ở 19,8%, còn Gemma 4 26B tụt xuống đáy bảng với vỏn vẹn 10,9%.
Xét về độ dài văn bản tạo ra trên mỗi lượt yêu cầu, người thật áp đảo hoàn toàn khi sản sinh trung bình 2.592 token, vượt xa mức 2.114 token của Claude Fable 5.1 và 1.537 token của GPT 6 Astra.
Các thảo luận trên diễn đàn Reddit chỉ ra điểm yếu lớn của các mô hình vừa và nhỏ: chúng rất dễ đánh mất tính mạch lạc khi xử lý các đề bài nhiều chương, đi kèm thói quen lặp lại câu từ nhàm chán. Trong khi đó, tác giả con người duy trì ưu thế nhờ khả năng triển khai cốt truyện phức tạp, tư duy ngẫu hứng và sự linh hoạt trong việc biến hóa phong cách hành văn xuyên suốt quá trình viết.