

Khánh Phạm✔
Writer
Trong bối cảnh các tác nhân AI dần được triển khai cho những nhiệm vụ quan trọng, độ tin cậy trở thành rào cản lớn nhất. Một tác nhân AI có thể giải quyết xuất sắc yêu cầu trong môi trường thử nghiệm hoặc bản demo, nhưng lại thất bại thảm hại khi đối mặt với chính tác vụ đó trong thực tế sản xuất. Sự thiếu nhất quán này chính là điểm nghẽn khiến các doanh nghiệp chần chừ trong việc ứng dụng AI vào những quy trình tài chính hay pháp lý khắt khe.
Thông tin chi tiết từ nghiên cứu trên Hugging Face đã chỉ ra rằng, các chỉ số đánh giá hiện nay thường bị 'đánh lừa' bởi giá trị trung bình. Lấy ví dụ từ hệ thống AppWorld, một tác nhân AI sử dụng GPT-4.1 có tỷ lệ thành công trung bình là 77,4% qua năm lần thử nghiệm. Tuy nhiên, nếu xét trên tiêu chí thành công tuyệt đối trong tất cả năm lần chạy, tỷ lệ này chỉ còn 53%. Khoảng cách 24,4 điểm chính là 'lỗ hổng nhất quán' mà hầu hết các báo cáo benchmark hiện nay đang vô tình che giấu.
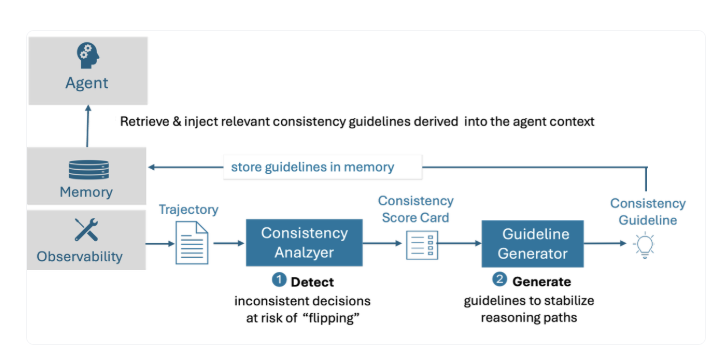
Nguyên nhân cốt lõi của sự bất ổn này thường xuất phát từ việc các mô hình đưa ra những quyết định 'sắc bén' nhưng thiếu sự ổn định (flat decisions). Để giải quyết bài toán này, các nhà nghiên cứu đã giới thiệu ALTK-Evolve, một hệ thống cải tiến giúp tối ưu hóa sự ổn định của tác nhân AI dựa trên việc phân tích các lộ trình thực hiện trong quá khứ. Thay vì chỉ học cách giải quyết một lần, hệ thống này giúp tác nhân rèn luyện sự nhất quán, giảm thiểu độ lệch giữa các lần thực hiện tác vụ.
Đối với các nhà phát triển, bài học rút ra ở đây là cần thay đổi tư duy đánh giá: đừng chỉ nhìn vào tỷ lệ thành công trên mỗi lần chạy đơn lẻ. Việc xây dựng các tiêu chuẩn đo lường sự nhất quán (consistency metrics) là bước sống còn trước khi đưa bất kỳ tác nhân AI nào lên môi trường thực tế. Hãy chú trọng vào việc chẩn đoán và sửa lỗi lộ trình thay vì chỉ cập nhật dữ liệu đầu vào, bởi sự ổn định trong kết quả chính là thước đo cao nhất cho năng lực thực sự của một tác nhân AI chuyên nghiệp.
Thông tin chi tiết từ nghiên cứu trên Hugging Face đã chỉ ra rằng, các chỉ số đánh giá hiện nay thường bị 'đánh lừa' bởi giá trị trung bình. Lấy ví dụ từ hệ thống AppWorld, một tác nhân AI sử dụng GPT-4.1 có tỷ lệ thành công trung bình là 77,4% qua năm lần thử nghiệm. Tuy nhiên, nếu xét trên tiêu chí thành công tuyệt đối trong tất cả năm lần chạy, tỷ lệ này chỉ còn 53%. Khoảng cách 24,4 điểm chính là 'lỗ hổng nhất quán' mà hầu hết các báo cáo benchmark hiện nay đang vô tình che giấu.
Nguyên nhân cốt lõi của sự bất ổn này thường xuất phát từ việc các mô hình đưa ra những quyết định 'sắc bén' nhưng thiếu sự ổn định (flat decisions). Để giải quyết bài toán này, các nhà nghiên cứu đã giới thiệu ALTK-Evolve, một hệ thống cải tiến giúp tối ưu hóa sự ổn định của tác nhân AI dựa trên việc phân tích các lộ trình thực hiện trong quá khứ. Thay vì chỉ học cách giải quyết một lần, hệ thống này giúp tác nhân rèn luyện sự nhất quán, giảm thiểu độ lệch giữa các lần thực hiện tác vụ.
Đối với các nhà phát triển, bài học rút ra ở đây là cần thay đổi tư duy đánh giá: đừng chỉ nhìn vào tỷ lệ thành công trên mỗi lần chạy đơn lẻ. Việc xây dựng các tiêu chuẩn đo lường sự nhất quán (consistency metrics) là bước sống còn trước khi đưa bất kỳ tác nhân AI nào lên môi trường thực tế. Hãy chú trọng vào việc chẩn đoán và sửa lỗi lộ trình thay vì chỉ cập nhật dữ liệu đầu vào, bởi sự ổn định trong kết quả chính là thước đo cao nhất cho năng lực thực sự của một tác nhân AI chuyên nghiệp.