

Thoại Viết Hoàng✔
Writer
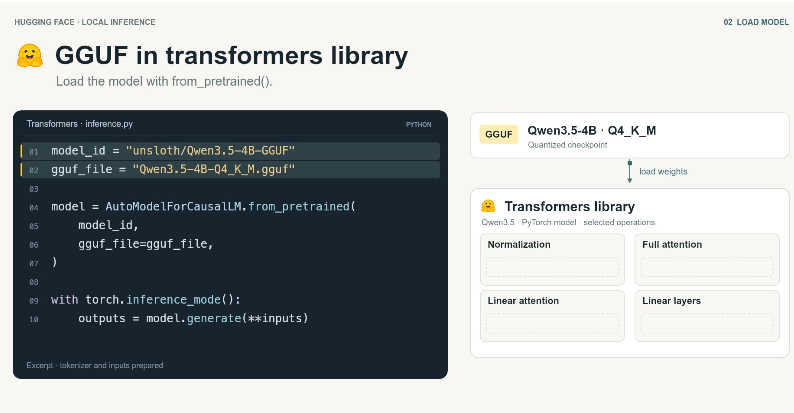
Việc chạy các mô hình ngôn ngữ lớn (LLM) trên máy tính cá nhân vừa trở nên dễ dàng và hiệu quả hơn bao giờ hết nhờ vào bước tiến mới trong hệ sinh thái của Hugging Face. Bằng cách tích hợp khả năng xử lý định dạng GGUF trực tiếp vào thư viện Transformers, người dùng hiện nay đã có thể nạp các mô hình đã được nén (quantized) trực tiếp từ bộ nhớ máy tính mà không cần đến các hạ tầng điện toán đám mây đắt đỏ.
Cơ chế kỹ thuật đằng sau sự đột phá này là sự kết hợp giữa các nhân xử lý Metal (cho Mac) và tối ưu hóa từ llama.cpp, cho phép tận dụng tối đa khả năng của cả CPU và GPU. Những mô hình có tham số lớn như Qwen3.6 27B giờ đây có thể vận hành trơn tru bên trong các tác nhân AI lập trình, mang lại hiệu suất gần như tương đương với các dịch vụ đám mây cao cấp nhất hiện nay.
Sự thay đổi này có ý nghĩa kinh tế cực kỳ lớn cho các nhà phát triển. Thay vì phải trả chi phí thuê GPU hàng tháng với mức giá trung bình khoảng 20 USD (khoảng 509.000 VNĐ) mỗi giờ cho các tác vụ suy luận nặng, họ có thể tận dụng phần cứng cá nhân để chạy các tác nhân AI với độ trễ thấp và bảo mật dữ liệu tuyệt đối. Định dạng GGUF, với hàng triệu lượt tải xuống, đã chính thức trở thành tiêu chuẩn công nghiệp cho suy luận cục bộ (local inference).
Người dùng cá nhân hoặc doanh nghiệp nhỏ hiện có thể trải nghiệm các tác nhân AI mạnh mẽ trên các công cụ như Ollama, LM Studio hay Jan mà không lo về chi phí vận hành tăng vọt. Đây là bài học thực hành quan trọng: việc nắm vững các công cụ nén mô hình không chỉ giúp tiết kiệm tài nguyên mà còn giúp tối ưu hóa luồng công việc tự động hóa, biến chiếc laptop của bạn thành một trung tâm trí tuệ nhân tạo riêng biệt. (Hugging Face)
Cơ chế kỹ thuật đằng sau sự đột phá này là sự kết hợp giữa các nhân xử lý Metal (cho Mac) và tối ưu hóa từ llama.cpp, cho phép tận dụng tối đa khả năng của cả CPU và GPU. Những mô hình có tham số lớn như Qwen3.6 27B giờ đây có thể vận hành trơn tru bên trong các tác nhân AI lập trình, mang lại hiệu suất gần như tương đương với các dịch vụ đám mây cao cấp nhất hiện nay.
Sự thay đổi này có ý nghĩa kinh tế cực kỳ lớn cho các nhà phát triển. Thay vì phải trả chi phí thuê GPU hàng tháng với mức giá trung bình khoảng 20 USD (khoảng 509.000 VNĐ) mỗi giờ cho các tác vụ suy luận nặng, họ có thể tận dụng phần cứng cá nhân để chạy các tác nhân AI với độ trễ thấp và bảo mật dữ liệu tuyệt đối. Định dạng GGUF, với hàng triệu lượt tải xuống, đã chính thức trở thành tiêu chuẩn công nghiệp cho suy luận cục bộ (local inference).
Người dùng cá nhân hoặc doanh nghiệp nhỏ hiện có thể trải nghiệm các tác nhân AI mạnh mẽ trên các công cụ như Ollama, LM Studio hay Jan mà không lo về chi phí vận hành tăng vọt. Đây là bài học thực hành quan trọng: việc nắm vững các công cụ nén mô hình không chỉ giúp tiết kiệm tài nguyên mà còn giúp tối ưu hóa luồng công việc tự động hóa, biến chiếc laptop của bạn thành một trung tâm trí tuệ nhân tạo riêng biệt. (Hugging Face)