

Vũ Nguyễn✔
Writer
Ngành công nghiệp trí tuệ nhân tạo vừa chứng kiến một bước tiến quan trọng trong việc định nghĩa lại cách thức con người giao tiếp với các mô hình ngôn ngữ lớn thông qua việc ra mắt LLMON (LLM Object Notation). Theo các thông tin từ Hugging Face, đây là một ngôn ngữ đánh dấu bản địa dành riêng cho AI, được thiết kế để truyền đạt cấu trúc và ngữ nghĩa một cách minh bạch thay vì dựa vào các chuỗi văn bản thuần túy. Bằng cách sử dụng các thẻ có ý nghĩa được bao bọc bởi các ký tự đặc biệt, LLMON cho phép mô hình phân biệt rõ ràng giữa dữ liệu đầu vào, chỉ dẫn thực thi và các yêu cầu ràng buộc. Cơ chế này loại bỏ sự nhập nhằng mà các mô hình ngôn ngữ hiện tại thường gặp phải khi xử lý các định dạng dữ liệu truyền thống.
Điểm yếu cố hữu của định dạng JSON trong việc giao tiếp với AI là nó được thiết kế cho các trình phân tích cú pháp (parser) thay vì các mô hình ngôn ngữ nhân quả. Trong môi trường JSON, một dấu ngoặc kép hoặc dấu hai chấm có thể bị mô hình nhầm lẫn giữa nội dung văn bản và ký tự điều khiển cấu trúc, dẫn đến việc diễn giải sai lệch dữ liệu. LLMON giải quyết triệt để vấn đề này bằng cách sử dụng một hệ thống các token đặc biệt dành riêng cho cấu trúc, tách biệt hoàn toàn với không gian từ vựng của nội dung chính. Phương pháp này giúp các mô hình duy trì khả năng nhận diện phân cấp phức tạp mà không cần phải thực hiện các phép đếm ký tự thủ công vốn là điểm yếu của các kiến trúc Transformer.
Để hiện thực hóa công nghệ này, hai phiên bản thử nghiệm là granite-4.1-3b-LLMON-preview và granite-4.1-8b-LLMON-preview đã được phát hành để cộng đồng nghiên cứu trải nghiệm. Các mô hình này được huấn luyện chuyên biệt để tiêu thụ và tạo ra văn bản dưới định dạng LLMON, đồng thời đi kèm với một bộ công cụ hỗ trợ chuyển đổi từ JSON sang LLMON mà không làm mất mát cấu trúc dữ liệu ban đầu. Người dùng có thể tích hợp chúng vào các quy trình làm việc hiện có một cách dễ dàng thông qua các thư viện hỗ trợ tích hợp sẵn. Điều này giúp các đội ngũ kỹ thuật tận dụng được khả năng kiểm soát dữ liệu chặt chẽ hơn mà không phải từ bỏ hoàn toàn các cấu trúc cũ.
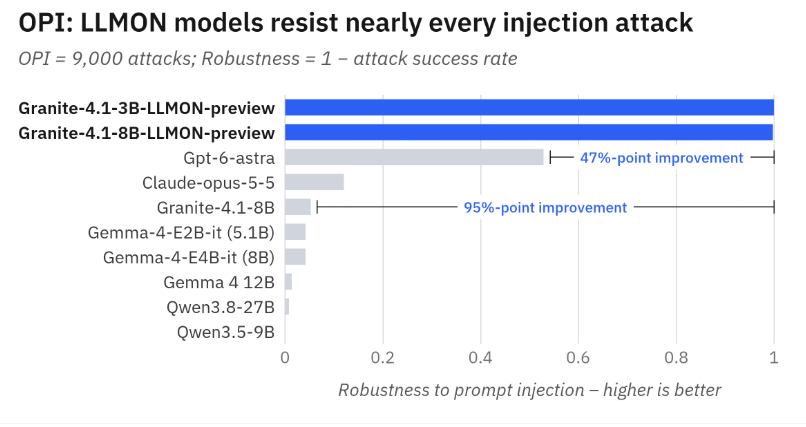
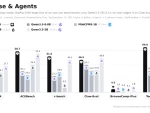
Một khía cạnh then chốt của LLMON chính là khả năng phòng chống các cuộc tấn công tiêm nhiễm lời nhắc gián tiếp (indirect prompt injection) một cách hiệu quả. Thông qua việc tách biệt rạch ròi giữa dữ liệu payload và các chỉ dẫn thực thi, mô hình không còn bị đánh lừa bởi các mã lệnh độc hại được cài cắm trong tài liệu truy xuất hoặc phản hồi từ công cụ. Kết quả đánh giá trên các tiêu chuẩn như OPI cho thấy các mô hình sử dụng LLMON giảm thiểu được tỉ lệ tấn công thành công tới 47% so với các mô hình tiên phong mạnh nhất hiện nay. Đây là minh chứng rõ ràng cho việc an toàn bảo mật có thể song hành cùng với khả năng suy luận logic của các tác nhân AI.
Khả năng ứng dụng của LLMON không dừng lại ở việc bảo mật, mà còn mở rộng sang việc quản lý các tác nhân AI phức tạp trong đa lượt hội thoại. Trong mỗi lượt phản hồi, hệ thống có thể gắn nhãn cụ thể cho từng thành phần, định rõ phần nào là chỉ dẫn cần thực thi và phần nào chỉ đóng vai trò là dữ liệu tham chiếu. Sự mạch lạc này cho phép mô hình hiểu sâu sắc hơn về nhiệm vụ cần hoàn thành thay vì chỉ cố gắng suy đoán từ một chuỗi văn bản hỗn hợp. Với việc không làm suy giảm hiệu năng trên các bài kiểm tra năng lực chung, LLMON hứa hẹn sẽ trở thành tiêu chuẩn mới cho các hệ thống AI đòi hỏi độ chính xác cao.
Điểm yếu cố hữu của định dạng JSON trong việc giao tiếp với AI là nó được thiết kế cho các trình phân tích cú pháp (parser) thay vì các mô hình ngôn ngữ nhân quả. Trong môi trường JSON, một dấu ngoặc kép hoặc dấu hai chấm có thể bị mô hình nhầm lẫn giữa nội dung văn bản và ký tự điều khiển cấu trúc, dẫn đến việc diễn giải sai lệch dữ liệu. LLMON giải quyết triệt để vấn đề này bằng cách sử dụng một hệ thống các token đặc biệt dành riêng cho cấu trúc, tách biệt hoàn toàn với không gian từ vựng của nội dung chính. Phương pháp này giúp các mô hình duy trì khả năng nhận diện phân cấp phức tạp mà không cần phải thực hiện các phép đếm ký tự thủ công vốn là điểm yếu của các kiến trúc Transformer.
Để hiện thực hóa công nghệ này, hai phiên bản thử nghiệm là granite-4.1-3b-LLMON-preview và granite-4.1-8b-LLMON-preview đã được phát hành để cộng đồng nghiên cứu trải nghiệm. Các mô hình này được huấn luyện chuyên biệt để tiêu thụ và tạo ra văn bản dưới định dạng LLMON, đồng thời đi kèm với một bộ công cụ hỗ trợ chuyển đổi từ JSON sang LLMON mà không làm mất mát cấu trúc dữ liệu ban đầu. Người dùng có thể tích hợp chúng vào các quy trình làm việc hiện có một cách dễ dàng thông qua các thư viện hỗ trợ tích hợp sẵn. Điều này giúp các đội ngũ kỹ thuật tận dụng được khả năng kiểm soát dữ liệu chặt chẽ hơn mà không phải từ bỏ hoàn toàn các cấu trúc cũ.
Một khía cạnh then chốt của LLMON chính là khả năng phòng chống các cuộc tấn công tiêm nhiễm lời nhắc gián tiếp (indirect prompt injection) một cách hiệu quả. Thông qua việc tách biệt rạch ròi giữa dữ liệu payload và các chỉ dẫn thực thi, mô hình không còn bị đánh lừa bởi các mã lệnh độc hại được cài cắm trong tài liệu truy xuất hoặc phản hồi từ công cụ. Kết quả đánh giá trên các tiêu chuẩn như OPI cho thấy các mô hình sử dụng LLMON giảm thiểu được tỉ lệ tấn công thành công tới 47% so với các mô hình tiên phong mạnh nhất hiện nay. Đây là minh chứng rõ ràng cho việc an toàn bảo mật có thể song hành cùng với khả năng suy luận logic của các tác nhân AI.
Khả năng ứng dụng của LLMON không dừng lại ở việc bảo mật, mà còn mở rộng sang việc quản lý các tác nhân AI phức tạp trong đa lượt hội thoại. Trong mỗi lượt phản hồi, hệ thống có thể gắn nhãn cụ thể cho từng thành phần, định rõ phần nào là chỉ dẫn cần thực thi và phần nào chỉ đóng vai trò là dữ liệu tham chiếu. Sự mạch lạc này cho phép mô hình hiểu sâu sắc hơn về nhiệm vụ cần hoàn thành thay vì chỉ cố gắng suy đoán từ một chuỗi văn bản hỗn hợp. Với việc không làm suy giảm hiệu năng trên các bài kiểm tra năng lực chung, LLMON hứa hẹn sẽ trở thành tiêu chuẩn mới cho các hệ thống AI đòi hỏi độ chính xác cao.