

Vũ Nguyễn✔
Writer
Rất nhiều mô hình ngôn ngữ lớn khi ra mắt đều tự công bố biểu đồ điểm số đứng đầu thế giới, nhưng khi người dùng thực tế mang về viết báo cáo hay lập trình lại thấy chất lượng kém xa kỳ vọng. Nguyên nhân đến từ hai yếu tố: một là hiện tượng 'rò rỉ đề thi' vào tập dữ liệu huấn luyện (data contamination) khiến mô hình học thuộc lòng câu trả lời của bộ câu hỏi mẫu; hai là chỉ cần thay đổi cách định dạng dấu ngoặc hoặc thứ tự phương án A, B, C, D trong câu lệnh chấm điểm cũng có thể làm điểm số của một mô hình dao động từ 10% đến 25%.
Sự thiếu nhất quán này khiến các doanh nghiệp rất dễ đưa ra quyết định sai lầm về mặt tài chính: bỏ tiền thuê các cổng API mô hình đóng đắt đỏ với giá từ $3 đến $15 cho một triệu token (~76.350 - 381.750 VNĐ) chỉ vì nhìn vào bảng quảng cáo, trong khi các mô hình trọng số mở miễn phí bản quyền ($0 ~ 0 VNĐ) hoặc cổng API giá rẻ như DeepSeek (1 Nhân dân tệ / 1M token ~3.560 VNĐ), Qwen 2.5 của Alibaba (0,8 Nhân dân tệ / 1M token ~2.850 VNĐ) hay Llama của Meta lại hoàn toàn đáp ứng tốt bài toán đó.
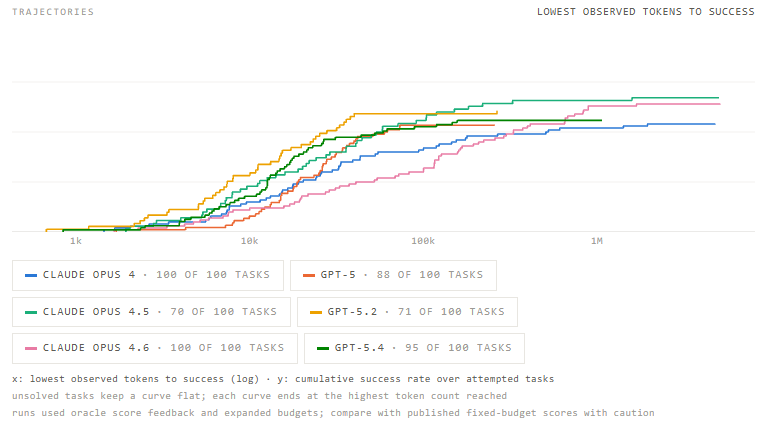
Nhằm chấm dứt tình trạng hỗn loạn của các bảng xếp hạng, Viện An toàn AI Vương quốc Anh (UK AISI) phối hợp cùng liên minh các nhà nghiên cứu độc lập vừa công bố trên Hugging Face sáng kiến chuẩn hóa đánh giá mô hình mang tên EvalEval, cung cấp bộ quy chuẩn kiểm chứng mở và độc lập.
Giá trị thực tiễn lớn nhất của bộ công cụ này là giúp các nhóm kỹ thuật tự tạo ra 'bộ đề thi nội bộ' gồm khoảng 50 đến 100 câu hỏi lấy trực tiếp từ dữ liệu công việc hàng ngày của chính công ty mình (như phân loại email tiếng Việt, trích xuất hợp đồng mẫu, viết truy vấn SQL nội bộ). Chỉ cần chạy thử bộ 100 câu hỏi này qua 3-4 mô hình với chi phí thử nghiệm chưa tới $1 (~25.450 VNĐ), doanh nghiệp sẽ biết chính xác mô hình nào vừa rẻ vừa đúng nhất với nghiệp vụ của mình.
Nguồn tham khảo: Huggingface
Sự thiếu nhất quán này khiến các doanh nghiệp rất dễ đưa ra quyết định sai lầm về mặt tài chính: bỏ tiền thuê các cổng API mô hình đóng đắt đỏ với giá từ $3 đến $15 cho một triệu token (~76.350 - 381.750 VNĐ) chỉ vì nhìn vào bảng quảng cáo, trong khi các mô hình trọng số mở miễn phí bản quyền ($0 ~ 0 VNĐ) hoặc cổng API giá rẻ như DeepSeek (1 Nhân dân tệ / 1M token ~3.560 VNĐ), Qwen 2.5 của Alibaba (0,8 Nhân dân tệ / 1M token ~2.850 VNĐ) hay Llama của Meta lại hoàn toàn đáp ứng tốt bài toán đó.
Nhằm chấm dứt tình trạng hỗn loạn của các bảng xếp hạng, Viện An toàn AI Vương quốc Anh (UK AISI) phối hợp cùng liên minh các nhà nghiên cứu độc lập vừa công bố trên Hugging Face sáng kiến chuẩn hóa đánh giá mô hình mang tên EvalEval, cung cấp bộ quy chuẩn kiểm chứng mở và độc lập.
Giá trị thực tiễn lớn nhất của bộ công cụ này là giúp các nhóm kỹ thuật tự tạo ra 'bộ đề thi nội bộ' gồm khoảng 50 đến 100 câu hỏi lấy trực tiếp từ dữ liệu công việc hàng ngày của chính công ty mình (như phân loại email tiếng Việt, trích xuất hợp đồng mẫu, viết truy vấn SQL nội bộ). Chỉ cần chạy thử bộ 100 câu hỏi này qua 3-4 mô hình với chi phí thử nghiệm chưa tới $1 (~25.450 VNĐ), doanh nghiệp sẽ biết chính xác mô hình nào vừa rẻ vừa đúng nhất với nghiệp vụ của mình.
Nguồn tham khảo: Huggingface