

The Storm Riders✔
Writer
Việc tra cứu qua chatbot AI đang dần trở thành thói quen phổ biến, nhưng một nghiên cứu mới cảnh báo rằng các mô hình này cung cấp phạm vi thông tin và góc nhìn hạn chế hơn đáng kể so với thao tác tìm kiếm thông thường trên Google.
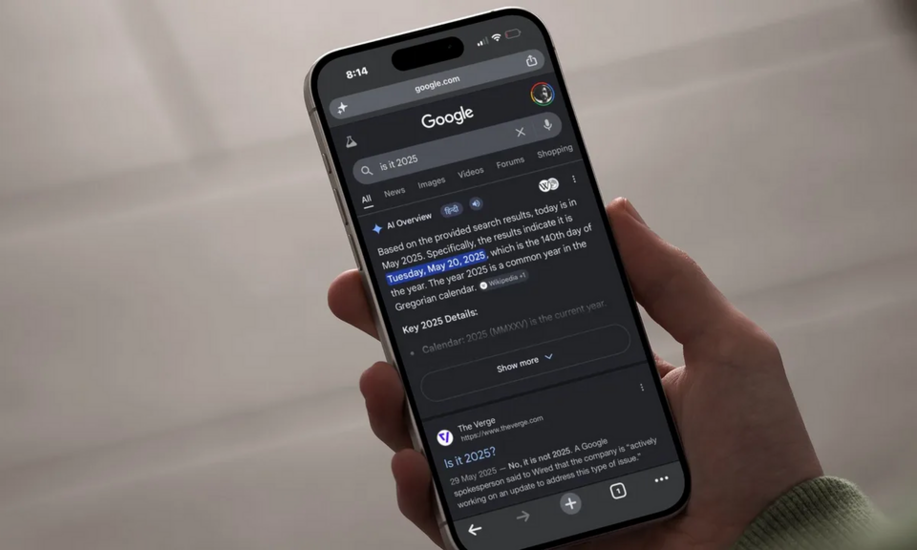
Để đưa ra kết luận này, các nhà nghiên cứu đã kiểm tra 27 mô hình ngôn ngữ lớn do OpenAI, Meta, Google và Alibaba phát triển trên 155 chủ đề gắn với 12 quốc gia. Các đề tài nghiên cứu trải rộng từ vũ khí hạt nhân, hôn nhân, nạn phân biệt chủng tộc, tội diệt chủng cho đến âm nhạc K-pop cùng nhiều vấn đề đặc thù của từng địa phương. Mỗi chủ đề được áp dụng 200 biến thể câu lệnh dựa trên các câu hỏi thực tế từ người dùng, tạo ra tổng cộng khoảng 1,7 triệu câu trả lời và 70 triệu luận điểm.
Khái niệm "lượng tri thức hạn hẹp hơn" trong nghiên cứu này nhấn mạnh vào sự thiếu hụt về độ phong phú chứ không phải độ dài ngắn của văn bản. Thay vì mở rộng nhiều chiều hướng tiếp cận, các chatbot AI có xu hướng lặp lại cùng một luồng thông tin và quan điểm. Trong khi đó, các công cụ tìm kiếm truyền thống có khả năng dẫn dắt người dùng đến nhiều trang web, nguồn dữ liệu và góc nhìn khác nhau, từ đó mở rộng nền tảng hiểu biết.
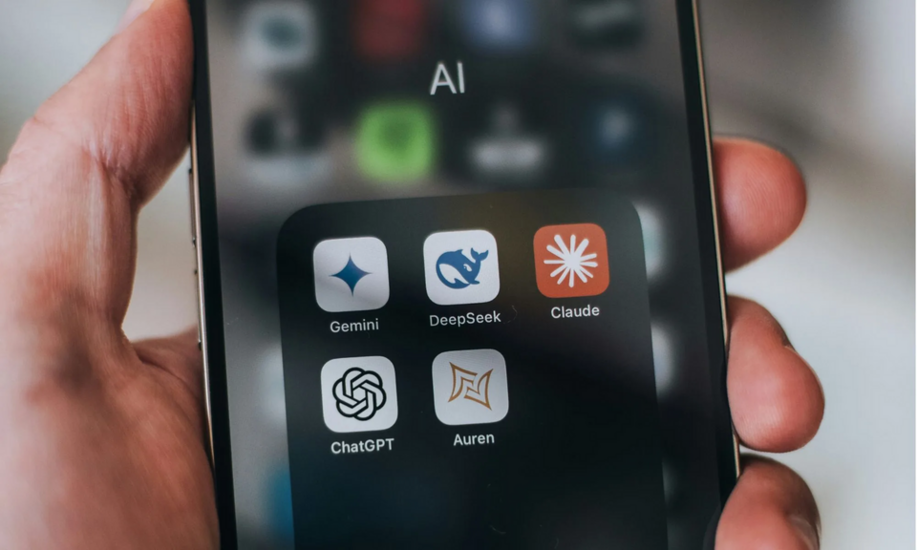
Nhóm nghiên cứu ghi nhận một phát hiện quan trọng: các mô hình quy mô nhỏ lại đưa ra câu trả lời đa dạng hơn mô hình lớn, và các phiên bản mới hơn cũng vượt trội hơn các bản phát hành cũ, dù không có hệ thống nào đạt đến mức độ phong phú của Google.
Lý do nằm ở chính cách thức hoạt động của các hệ thống AI. Về bản chất, chúng nén dữ liệu văn bản dùng trong quá trình huấn luyện, giữ lại các khuôn mẫu phổ biến nhất và loại bỏ những yếu tố bất thường hoặc ít gặp.
Các nhà nghiên cứu gọi hiện tượng này là "suy thoái tri thức" (knowledge collapse). Dù kịch bản này chưa thực sự diễn ra nhờ các thế hệ mô hình mới vẫn có độ đa dạng nhỉnh hơn, nhưng cơ chế hình thành rủi ro đã bắt đầu vận hành. Nhóm tác giả cũng đã xây dựng một phương pháp giúp các nhà phát triển đo lường mức độ đa dạng trên mô hình của họ.
Trước thực tế đó, người dùng không nên xem các bản tóm tắt của AI là nguồn tham khảo duy nhất. Việc chủ động đối chiếu qua nhiều nguồn tài liệu khác nhau vẫn là bước cần thiết để tiếp cận đầy đủ bối cảnh cùng các góc nhìn đa chiều.
Mức độ đồng nhất trong câu trả lời của các mô hình ngôn ngữ
Kết quả từ nghiên cứu của Đại học Copenhagen chỉ ra rằng mọi mô hình AI tham gia thử nghiệm đều đưa ra câu trả lời có tính đồng nhất cao hơn so với kết quả tìm kiếm thông thường trên Google. Ngay cả GPT-5 của OpenAI, cái tên có phản hồi phong phú nhất trong danh sách khảo sát, vẫn ghi nhận mức độ đa dạng kém hơn Google ít nhất 18,7%.Để đưa ra kết luận này, các nhà nghiên cứu đã kiểm tra 27 mô hình ngôn ngữ lớn do OpenAI, Meta, Google và Alibaba phát triển trên 155 chủ đề gắn với 12 quốc gia. Các đề tài nghiên cứu trải rộng từ vũ khí hạt nhân, hôn nhân, nạn phân biệt chủng tộc, tội diệt chủng cho đến âm nhạc K-pop cùng nhiều vấn đề đặc thù của từng địa phương. Mỗi chủ đề được áp dụng 200 biến thể câu lệnh dựa trên các câu hỏi thực tế từ người dùng, tạo ra tổng cộng khoảng 1,7 triệu câu trả lời và 70 triệu luận điểm.
Khái niệm "lượng tri thức hạn hẹp hơn" trong nghiên cứu này nhấn mạnh vào sự thiếu hụt về độ phong phú chứ không phải độ dài ngắn của văn bản. Thay vì mở rộng nhiều chiều hướng tiếp cận, các chatbot AI có xu hướng lặp lại cùng một luồng thông tin và quan điểm. Trong khi đó, các công cụ tìm kiếm truyền thống có khả năng dẫn dắt người dùng đến nhiều trang web, nguồn dữ liệu và góc nhìn khác nhau, từ đó mở rộng nền tảng hiểu biết.
Nguyên nhân khiến phản hồi của AI kém phong phú
Nhóm nghiên cứu ghi nhận một phát hiện quan trọng: các mô hình quy mô nhỏ lại đưa ra câu trả lời đa dạng hơn mô hình lớn, và các phiên bản mới hơn cũng vượt trội hơn các bản phát hành cũ, dù không có hệ thống nào đạt đến mức độ phong phú của Google.
Lý do nằm ở chính cách thức hoạt động của các hệ thống AI. Về bản chất, chúng nén dữ liệu văn bản dùng trong quá trình huấn luyện, giữ lại các khuôn mẫu phổ biến nhất và loại bỏ những yếu tố bất thường hoặc ít gặp.
Nguy cơ suy thoái tri thức khi AI học từ dữ liệu nhân tạo
Bà Isabelle Augenstein, tác giả chính của nghiên cứu, lo ngại rằng hiện tượng này có thể tạo ra một vòng lặp tự suy giảm. Nếu các mô hình tương lai được đào tạo dựa trên những văn bản do chính AI tạo ra – vốn đã ít phong phú hơn nội dung do con người viết – từng thế hệ tiếp theo sẽ càng bị thu hẹp góc nhìn và dần làm xói mòn lượng thông tin mà AI có thể cung cấp.Các nhà nghiên cứu gọi hiện tượng này là "suy thoái tri thức" (knowledge collapse). Dù kịch bản này chưa thực sự diễn ra nhờ các thế hệ mô hình mới vẫn có độ đa dạng nhỉnh hơn, nhưng cơ chế hình thành rủi ro đã bắt đầu vận hành. Nhóm tác giả cũng đã xây dựng một phương pháp giúp các nhà phát triển đo lường mức độ đa dạng trên mô hình của họ.
Trước thực tế đó, người dùng không nên xem các bản tóm tắt của AI là nguồn tham khảo duy nhất. Việc chủ động đối chiếu qua nhiều nguồn tài liệu khác nhau vẫn là bước cần thiết để tiếp cận đầy đủ bối cảnh cùng các góc nhìn đa chiều.